2026年9月10日、OpenAIは「今や誰もがデータを活用できる」を公開し、ChatGPT Work向けの新しい「Data agent」を発表しました。企業が保有するデータや文書へ自然言語で問いかけ、分析を進めたり、インタラクティブなダッシュボードを作成したりできる機能です。
これまでデータ部門やSQLを扱える担当者へ依頼していた分析を、より多くの社員が自分で進められる可能性があります。一方で、企業データを生成AIへ接続できることと、分析結果を安心して業務判断に使えることは同じではありません。
OpenAIが2026年1月に公開した社内専用データエージェントの事例や、dbt Labsが説明するSemantic Layerの役割まで見ると、企業がデータ分析AIを使うために整えておきたい土台が見えてきます。
ChatGPT Workの「Data agent」は企業データ分析をどう変えるのか
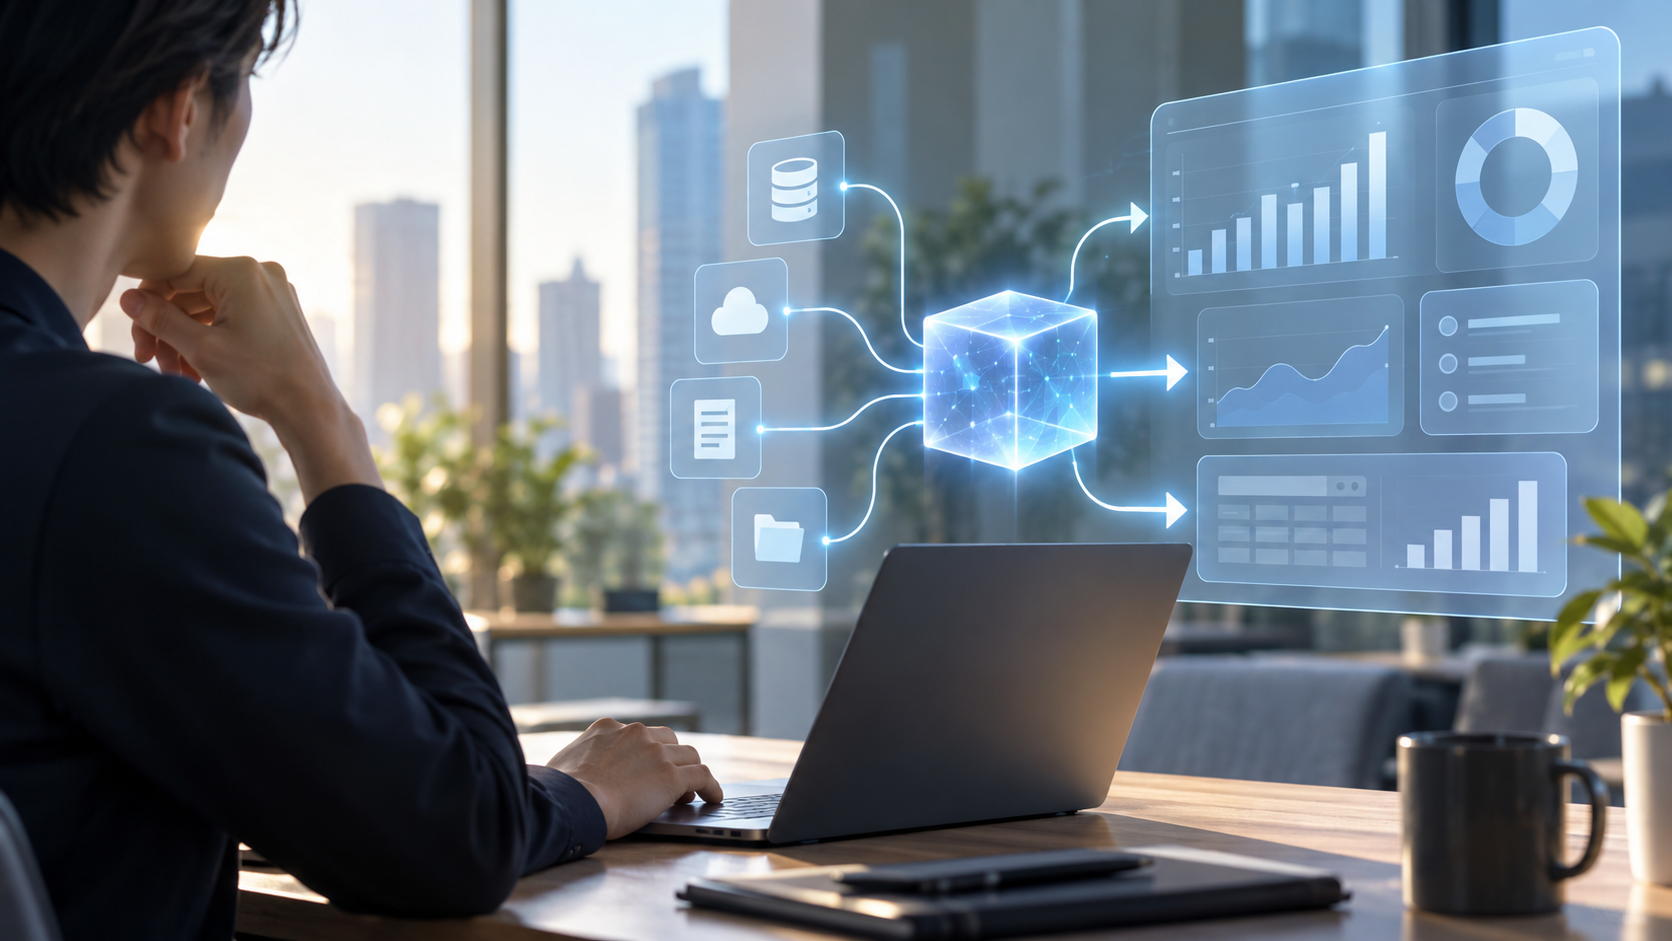
Data agentは、企業データに自然言語で質問し、分析を指示したり、結果を掘り下げたりできるChatGPT Workの機能です。OpenAIは、Amazon Redshift、Datadog、Google BigQuery、ClickHouse、Databricks、MongoDB、Snowflakeなどを接続対象の例として挙げています。GoogleドライブやSharePointに保存されたファイルや文書も分析へ取り込めます。
特徴は、データの値だけを見るのではなく、組織固有のビジネス用語やメトリックの定義、カスタム計算、データ同士の関係も使って内容を解釈する点です。OpenAIは、こうした情報の取得元としてセマンティックレイヤー、Databricks Genie Ontology、dbt、GitHub、Snowflake Horizon、BIダッシュボードなどを挙げています。
利用者は分析結果へ追加で質問し、各結果の根拠を確認できます。分析内容からインタラクティブなダッシュボードを作ることもでき、Omni、Oracle BI、Power BI、Sigma、Tableau、ThoughtSpotなど既存のBIツールとも連携できます。さらに、Slackやメールで結果を共有したり、ユーザーが承認した操作を接続済みツールで実行したりすることも想定されています。
ただし、接続した企業データを誰でも自由に見られる仕組みではありません。Enterprise管理者が利用可能なデータ接続と利用できる役割を選択し、クエリには接続先アカウントに設定済みの権限が適用されます。テーブル、行、列単位の制限も引き継がれます。
Data agentはChatGPT WorkのPlugins directoryで「Data」として提供され、管理者がチーム向けに有効化またはインストールし、必要なデータソース側のプラグインも設定します。
OpenAIは、Data agentを支える機能を社内でも広く利用しており、プロダクト部門のほぼ全員とGTM組織の3分の2超がデータエージェントを使っていると説明しています。ただし、これはOpenAI社内の利用状況であり、一般企業でも同じ利用率や効果が得られることを示す数字ではありません。
今回確認した発表資料からは、Data agentの詳細な料金体系や、すべてのプラン・地域における具体的な提供条件までは確認できません。
1月の社内事例と比べると、「データにつなぐ」以外の準備も見えてくる
9月の発表では、自然言語による分析や複数のデータソースとの接続といった利便性が示されています。しかし、OpenAIが2026年1月に公開した社内データエージェントの事例を見ると、企業データをAIで扱うために、データ接続以外の仕組みも整えられていました。
1月の記事で紹介されたのは、OpenAIのデータ、権限、ワークフローに合わせて作られた、外部提供ではない社内専用のカスタムツールです。9月に発表されたChatGPT WorkのData agentと同一製品であることは資料から確認できないため、1月の内部構造をそのまま製品版の仕様として扱うことはできません。
一方、社内事例は「企業データをAIに分析させるとき、何が難しくなるのか」を理解する材料になります。
OpenAIのデータ基盤は、1月の記事公開時点で3500人を超える社内ユーザーに利用され、7万件のデータセット、600PBを超えるデータを扱っていました。似たテーブルが多数存在する環境では、分析したい内容に合うテーブルを探すこと自体が難しく、正しいテーブルを選んだ後も、結合やフィルターを誤れば分析結果が崩れる可能性があります。
そのためOpenAIの社内エージェントは、列名やデータ型といった基本情報だけでなく、過去のクエリ、人間が付けた説明、コードから読み取ったデータの意味、社内文書や標準的な指標定義、過去の修正内容、実行時に取得する最新情報など、複数の種類のコンテキストを利用していました。
アクセス制御も、AI独自の仕組みに置き換えたわけではありません。OpenAIの既存のセキュリティ・アクセス制御モデルを継承し、利用者は自分がすでに権限を持っているテーブルだけを問い合わせられる設計です。
さらに、分析品質を確かめる仕組みも設けています。重要な分析パターンについて、人間が用意した正解となるSQLとエージェントが生成したSQLの結果を比較し、機能追加によって品質が下がっていないかを継続的に評価しています。利用者側でも、回答の前提や実行手順の概要、クエリ結果の元データを確認できるようにしています。
9月のData agentと1月の社内専用エージェントが同一製品であることは確認できません。ただし、両資料では、企業データをAIにつなぐだけでなく、「誰が見られるか」「データをどう解釈するか」「結果をどう確かめるか」が重視されています。
社内データをAIに任せる前に確認したい「3つの導入条件」
ここまでのOpenAIの2資料とdbt Labsの資料を横断すると、Data agentのようなデータ分析AIを導入する際に確認したいポイントを、「権限」「共通定義」「検証」の3つに整理できます。
これはOpenAIやdbt Labsが公式に示した「3条件」ではなく、Focus4編集部が各資料の内容を基にまとめた導入判断の軸です。
1.権限――AIにつないでも「見てよいデータ」の範囲は変えない
Data agentは、接続先アカウントに設定されている既存の権限をクエリにも適用します。OpenAIの社内エージェントも、既存のアクセス制御モデルを引き継ぐ設計でした。
このため導入前に確認したいのは、「AIが高度なアクセス制御を自動で作ってくれるか」ではありません。現在のデータ基盤で、誰がどのテーブル、行、列まで閲覧できるのかが適切に設定されているかです。
Data agentが既存の権限を引き継ぐことは示されていますが、元のデータ基盤にある権限設計そのものを自動的に見直したり修正したりする機能は、今回の資料からは確認できません。
Data agent型の仕組みを検討するときは、まず「現在の権限設計をそのままAIへ引き継げる状態か」を確認することが判断材料になります。
2.共通定義――「売上」「顧客」「利用者数」の意味を組織でそろえる
自然言語で質問できても、質問に使う言葉の意味が組織内で統一されていなければ、分析の前提がそろいません。
Data agentは、組織のビジネス用語、メトリック定義、カスタム計算、データ間の関係をコンテキストとして使います。OpenAIの社内事例でも、人間による説明や社内ナレッジ、主要メトリックの標準定義などを組み合わせていました。
ここで参考になるのが、OpenAIがData agentのコンテキスト取得元の一つとして挙げている「セマンティックレイヤー」です。簡単にいえば、「売上」「継続率」といった重要な指標を、ツールごとに別々に定義するのではなく、共通の意味として管理する仕組みです。
dbt Labsはdbt Semantic Layerについて、既存のデータモデル上でメトリックを定義し、その定義を一元化することで、異なる部門や下流のツールでも同じ定義を利用できると説明しています。dbt側で定義が変更されれば、その定義を利用する場所にも反映されます。
つまり、生成AIが自然な言葉を扱えるようになっても、社内で「売上」に何を含めるのか、「利用者数」をどの期間・条件で数えるのかといった定義の不一致を、自動的に解消する機能は今回の資料から確認できません。
導入前には、重要な指標や社内用語について共通の定義があり、AIが参照できる形になっているかを確認することが判断材料になります。
3.検証――AIの答えをそのまま最終結果にしない
3つ目は、AIが出した分析結果を人間が確かめられることです。
OpenAIの社内エージェントでは、人間が用意した正解SQLと生成されたSQLの結果を比較する継続的な評価を行っています。また、利用者が回答の前提や実行手順、元データへ戻って確認できるようにしています。
9月に発表されたData agentでも、分析結果へ追加質問を行い、それぞれの結果の根拠を確認できると説明されています。
すべての企業がOpenAIと同じ評価システムを作る必要があるわけではありません。しかし、少なくとも重要な分析について、人間が結果を確認できるか、根拠となったデータへ戻れるか、繰り返し使う分析の妥当性を確認する運用を作れるかは、導入判断の材料になります。
特に、売上や支出、顧客動向など、そのまま意思決定へ使われる数字では、「AIが答えた」という事実だけを正しさの根拠にしない仕組みが重要です。
Data agent導入で最初に確認するのは「接続数」ではなく、分析を任せられる土台
Data agentによって、これまでクエリ作成や分析ツールの習得が必要だった企業データ分析を、より多くの社員が自然言語から始められる可能性が広がりました。売上や支出、顧客、製品利用などの社内指標を扱う仕事では、専門部署へ分析を依頼していた場面の一部が変わる可能性があります。
一方、今回の3資料を横断すると、導入時に確認したいのは「何種類のデータソースにつながるか」だけではありません。
自社でData agent型のデータ分析AIを検討するなら、少なくとも次の3点を確認できます。
- 権限:現在のデータアクセス権限を、そのままAIへ適用できる状態になっているか
- 共通定義:重要な指標、社内用語、計算方法が組織内で共通化されているか
- 検証:AIが出した分析の根拠や結果を、人間が確認できる運用を作れるか
この3点のどこかが未整備なら、生成AIの導入だけを先に考えるのではなく、データ基盤や社内運用の整備も一緒に検討するのが妥当です。
自然言語で分析できることは、データ活用の入口を大きく広げます。ただし、その分析を実際の仕事へ安心して使える状態にするには、「正しい人が、共通の意味を持つデータを使い、結果を確かめられる」という土台まで含めて考えることが重要です。
出典:OpenAI「今や誰もがデータを活用できる」
https://openai.com/index/put-data-to-work/
出典:OpenAI「OpenAI の自社データエージェントの内部」
https://openai.com/ja-JP/index/inside-our-in-house-data-agent/
出典:dbt Labs「dbtセマンティックレイヤー」
https://docs.getdbt.com/docs/use-dbt-semantic-layer/dbt-sl?version=2