2026年8月20日、Cohere Labsは「The Culture Funnel: You can’t align what isn’t in the data」を公開しました。大規模言語モデル(LLM)の学習データに含まれる文化的な情報が、学習工程を通じてどのように変化するかを分析した研究です。
生成AIは多くの言語を自然に扱えるようになっています。しかし、ある言語を流暢に使えることと、その地域の慣習や価値観、対人関係の前提まで扱えることは同じなのでしょうか。Cohere Labsは、AIの出力段階だけではなく、モデルが学ぶデータそのものに着目して、この問題を調べました。
Cohere LabsはAIの「文化」を学習データからどう調べたのか
Cohere Labsが分析したのは、LLMの学習工程に使われる560万件超の学習データサンプルです。対象にはpretraining(事前学習)から、SFT、alignment、reasoningといった後段の学習まで、それぞれの段階で使われる代表的なデータセットが含まれます。
研究では、各データセットから抽出したプロンプトに、Cohereの「Command A」を使って文化的なシグナルを自動でタグ付けしました。そのうえで、6言語にまたがる一部のプロンプトを人手でも確認し、自動生成したタグの品質を検証しています。
ここで重要なのは、Cohere Labsが「言語」や「地域」をそのまま「文化」とみなしていない点です。分析では、domain(分野)、task intent(タスクの目的)、language(言語)、geolocation(地域)、cultural characteristics(文化的特徴)という複数の側面から文化的な情報を捉えています。
つまり、560万件超という数字はAI利用者へのアンケート人数ではありません。モデルの学習工程にあるデータサンプルを分析した規模です。
学習が進むほど文化的な情報が細る「カルチャーファネル」
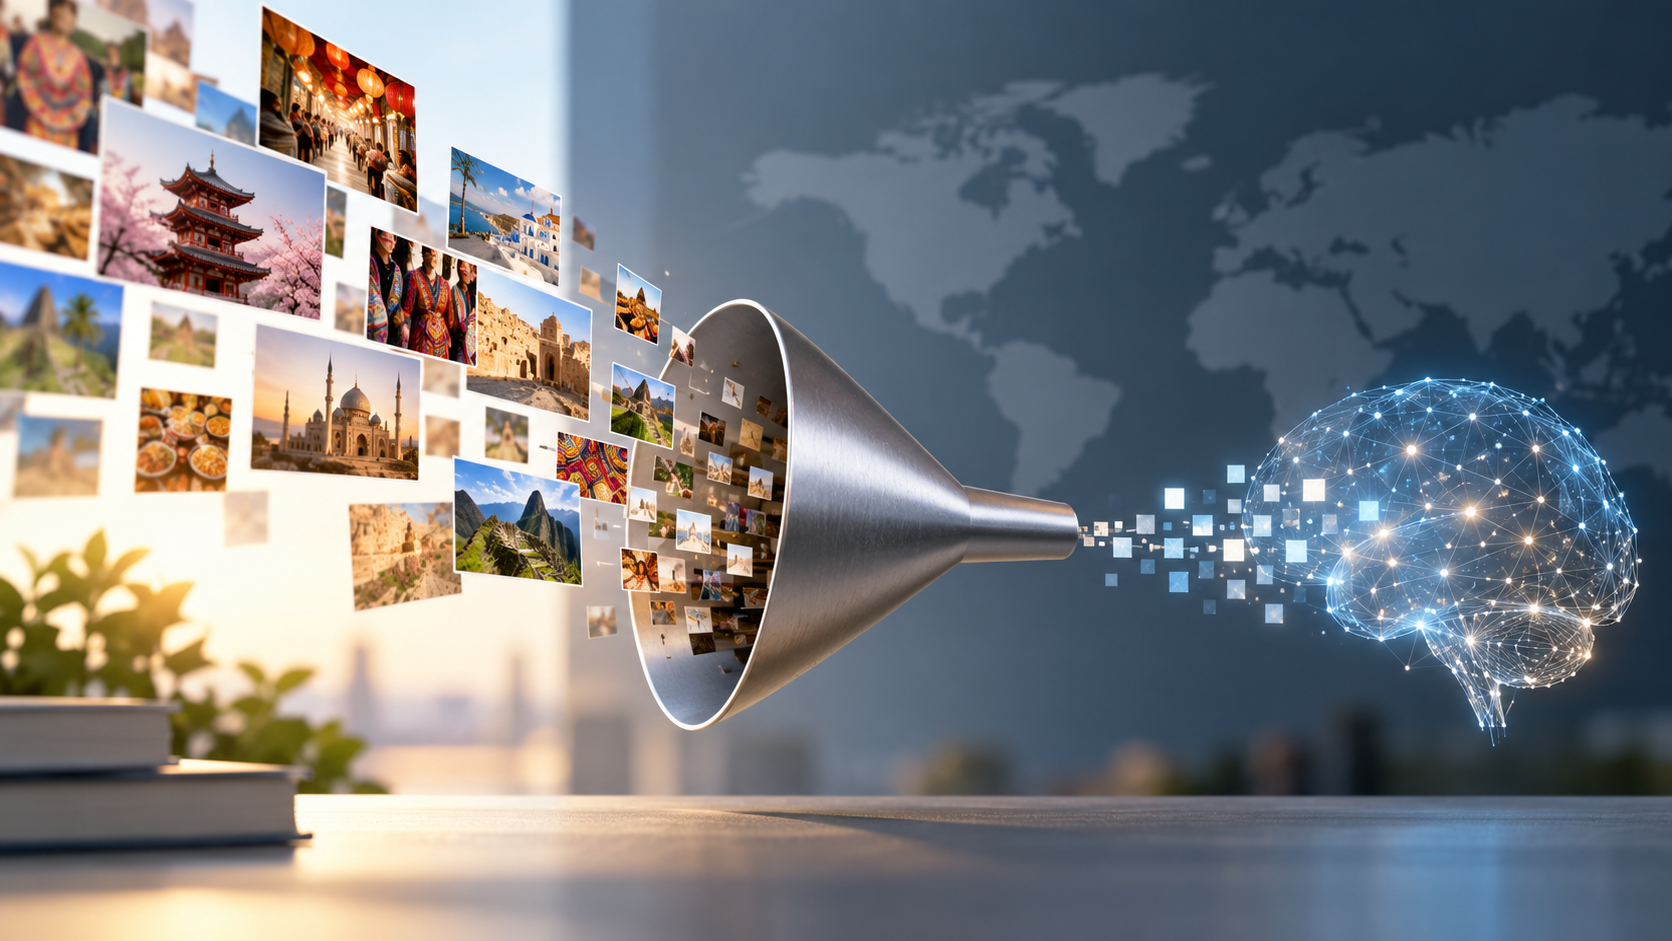
分析でCohere Labsが確認した中心的な傾向は、事前学習のデータと比べ、後学習のデータでは文化マーカーを含む割合が小さくなることでした。同社は、学習工程を進むにつれて文化的な多様性が狭まるこの現象を「culture funnel(カルチャーファネル)」と呼んでいます。
Cohere Labsは、その背景に関係する要素の一つとして、推論やアラインメントを改善する後学習データでは、数学の計算やコード作成など技術的なタスクが重視される傾向を挙げています。こうしたデータ構成では、文化マーカーを比較的多く含むデータの比重が小さくなり、モデルが多様な文化的知識を学ぶ機会が減る可能性があると分析しています。
また、残っている文化的な内容も、食べ物、祝日、固有名詞、翻訳の文脈など、比較的はっきり表れる文化知識へ偏る傾向が示されました。Cohere Labsは、暗黙の文化的な好みや社会的な規範、人と人との関係性を考える必要がある課題では、より難しさが残ると説明しています。
ただし、ここから「数学やコードを学習させるとAIの文化理解が失われる」と因果関係を断定することはできません。研究が示しているのは、学習段階によってデータに含まれる文化的なシグナルの割合が変化するという観測結果です。
言語を増やしても「文化」が同じ割合で増えるわけではない
もう一つの重要な結果が、多言語化と文化的な多様性は同じ動きをしないという点です。
Cohere Labsの分析では、データセットへ言語を追加すると、含まれる固有の地域数は増えました。一方で、文化的な内容がデータ全体に占める割合は、言語数の増加に合わせて伸び続けるのではなく、頭打ちになる傾向が確認されています。
文化的な内容の割合は、単純な言語数だけではなく、どのようにデータを選び、集めるかにも左右されます。Cohere Labsは例としてAyaを挙げ、国際的なコミュニティーから文化に根差したプロンプトや回答を意図的に集めたため、文化的な内容の割合が高かったと説明しています。
さらに、地域分布にも偏りがありました。文化的なタグが付いたデータではインドが最も頻繁に現れ、アジアや欧州の国へ集中する傾向が確認されています。Cultura Xの例では、上位50地域に入った南米、アフリカ、北米の国は、それぞれ1か国でした。他のデータセットでは、中国や米国も上位10地域に入る主要な地域だったとしています。
つまりCohere Labsの分析からは、対応する言語や地域が増えることと、多様な文化的文脈が十分な割合で学習データへ含まれることは、別の問題だと分かります。「多言語AIなら文化も自動的に幅広く扱える」とは限らないということです。
翻訳やメッセージ作成では、言葉の自然さだけで判断しない
では、生成AIを仕事で使う側は何を意識すればよいのでしょうか。Cohere Labsの学習データ分析では、翻訳、地域情報の問い合わせ、メッセージ作成で比較的強い文化的シグナルが確認されました。
また、学習データの分析結果をユーザー調査と比較すると、文化理解の改善を求める声が特に多かった用途として、クリエイティブライティング、翻訳、メール・メッセージ作成が挙げられています。ただし、ブログ本文にはこのユーザー調査の母数や地域、実施時期、方法は示されていないため、割合や代表性までは判断できません。
ここからはCohere Labsの公式な企業向けチェックリストではなく、研究結果を基にFocus4が一般のAI利用者向けに整理した判断材料です。文化的な違いが結果を左右しやすい仕事では、次の3点を確認するとよいでしょう。
- 地域の慣習や価値観が答えを左右するか: 礼儀、暗黙の前提、人間関係、地域固有の常識などによって適切な表現が変わる仕事かを確認します。
- 文化との関係が強い用途か: 翻訳、地域情報、メール・メッセージ、クリエイティブライティングなど、今回の分析やユーザー調査で文化との関係が示された用途では特に注意します。
- 文章の流暢さだけを正しさの根拠にしていないか: 自然な日本語や外国語が出ていても、地域の慣習や社会的な前提まで適切とは限りません。
文化への依存度が高い出力では、そのまま採用せず、対象地域について知識を持つ人に確認してもらう、必要な文化的背景をプロンプトに明示して再確認するといった対応が考えられます。特に海外向けの文章や対人コミュニケーションでは、「言葉が自然か」と「文化的に適切か」を分けて見ることが重要です。
文化的な特徴を学習データで明示する実験では改善も確認された
Cohere Labsは、文化的な情報が学習データから狭まる現象を示すだけでなく、文化的な側面を学習データ上で明示する実験も行っています。
TinyAyaのファインチューニングでは、学習データそのものの分布を変えず、各学習サンプルに文化的なメタ情報を追加しました。その結果、文化関連のベンチマークでNormAdは+8%、BBQは+6%、GMMLUは+2.3%の改善を観測したと報告しています。また、一般的な多言語能力を犠牲にせず改善が見られたとしています。
一方、文化マーカーを付けずに「より文化的なデータ」を追加する方法では、文化関連ベンチマークでの改善幅が小さく、一般的な能力も低下したとCohere Labsは説明しています。ただし、これはTinyAyaを使った研究上の実験結果であり、すべての生成AIで同じ改善幅が得られることを意味しません。
Cohere Labsは、単に対応言語を増やすだけではなく、言語、地域、分野、タスクの目的をまたいで文化的な表現を意図的にバランスさせることを推奨しています。また、学習時に文化的な側面を明示することも、十分に表れにくい文化的特徴をモデルが保持し、学ぶ助けになるとしています。
生成AIの文化対応を考えるとき、「何言語を使えるか」は一つの指標にすぎません。利用者がモデル内部の学習データを直接確認できない場合でも、文化的な前提が重要な仕事では、出力の流暢さとは別に内容を確かめることが判断材料になります。
出典:Cohere Labs「The Culture Funnel: You can’t align what isn’t in the data」