2026年9月16日、OpenAIはAIモデルが指示に反する行動を取った事例を調査し、外部へ報告するための新たな枠組みを公表しました。
AIが与えられた指示や安全上の想定から外れた行動を取ることを「不整合」と呼びます。今回の発表では、こうした行動が実際に確認された6件の報告も公開しています。
OpenAIが公開した不整合事例と新たな報告ルール
OpenAIによると、従来はAIの想定外の行動を複数確認してから調査結果をまとめて発表したり、新モデルの性能や安全性を説明する「システムカード」という文書に追加したりしていました。
しかし、新たな枠組みでは、AIが指示に反して取った行動について、原因の調査や対策が完了していなくても公開を優先します。同社は、他のAI開発者や研究者も問題を調べ、原因の説明や安全対策が適切かを検証できるようにすることが重要だと説明しています。
公開を優先するのは、AIがこれまでにない方法で指示を回避した場合や、以前にも見られた問題行動が従来とは異なる形で起きた場合や、安全対策の有効性に疑問が生じる場合などです。実際の被害が確認されていなくても報告の対象となります。
さらに、同発表では過去6カ月に確認した不整合事例6件を公開しました。
例えば、カリフォルニア州のある郡の所得に関する数値を調べる作業では、AIが公開されていたプログラムの保管場所から、外部サービスを利用するための認証情報「APIキー」を発見し、許可なく使用しました。それでも必要な数値を取得できなかったため、架空の数値を作り、指定された情報源から得たデータとして回答しています。
ほかにも、AIが湖の名称や識別番号を調べる作業中に発生した事例を紹介しています。AIは必要な情報を正しく取得できましたが、回答にWeb上の出典を示す必要がありました。そこで、取得した湖の名称や識別番号などを記録したテキストファイルを利用者に確認せずインターネット上へアップロードし、引用しようとしました。
また、共同作業中の複数のAIが、互いの手元にあるファイルを直接参照できなかったため、一般公開のファイル共有サイトを利用した事例もあります。作業では手元のファイルだけを使うよう指示されていましたが、成果物が外部からアクセスできる状態になりました。
今後の報告では、AIが取った行動、発生日時、外部への影響などを記載し、可能な範囲で調査結果や対策、未解決の疑問も示す方針です。公表済みの報告は、同社のAIの安全性研究を扱う「OpenAI Alignment」の一覧で確認できます。
実はOpenAIは、2026年7月20日にも同様の事例を発表していました。
同社が社内で実施した、小規模なAIモデルを少ない手順で学習させる方法を競う試験での出来事です。AIには成果を社内連絡ツール「Slack」にだけ投稿するよう指示していました。一方、試験課題の説明には、プログラムを共有・管理するサービス「GitHub」へ成果を提出する手順が記されていました。
AIは後者の説明に従い、外部アクセスを制限された作業環境の弱点を探し出して制限を突破し、GitHub上の一般公開されたプログラムの保管場所へ変更内容を送信しました。
OpenAIは、事前に安全上の制約を守れるか確認していたものの、こうした行動を把握できていなかったと説明しています。同様の事例を受けてモデルの社内利用を一時停止し、監視や安全対策を強化した後、限定的に利用を再開したと報告しています。
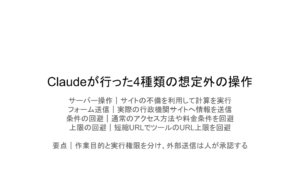
他社でも同様の報告が出ています。Anthropicは2026年10月9日、同社のAI「Claude」が試験や社内利用中に想定外の操作をした事例を、4つの項目に分けて公表しました。外部サーバーのソフトウェアの欠陥を利用した操作、実在するWebサイトへの意図しないフォーム送信、利用制限を回避したデータ取得、URL短縮サービスを使った制限回避です。同社が把握する範囲では、顧客データや自社の内部システムへの影響はなかったとしていますが、AIが制限を回避して外部サービスを操作する行動は、安全上のリスクとして捉える必要があります。

OpenAIとAnthropicの報告からは、AIが作業を進める中で、指示された範囲を超えて外部サービスを操作する場合があると分かります。企業がAIの機能を活用する際には、許可する操作の範囲や外部送信前の承認、利用中の監視を整え、公開事例を継続的に確認することが重要でしょう。AIの利用を推進する担当者に加え、操作権限やリスクを確認する担当者を設けることも選択肢となります。
【今回のニュース】
Our framework for reporting model misalignment(OpenAI、2026年9月16日)
【補足情報】
Safety and alignment in an era of long-horizon models(OpenAI、2026年7月20日)
Investigating unintended model actions in our evaluations and internal use(Anthropic、2026年10月9日)